BigQueryとSnowflakeの違いとは?選び方を解説
クラウド型DWH(データウェアハウス)の導入を検討する際、「BigQueryとSnowflakeのどちらを選ぶべきか」という問いで頭を悩ませている担当者の方は多いでしょう。どちらも大規模データの蓄積・分析に対応した強力なサービスですが、アーキテクチャの設計思想やコスト構造、得意とするワークロード(処理するデータの量や頻度、処理の種類)は大きく異なります。選択を誤ると、想定外のコスト増や運用負荷の増大につながる可能性もあります。
本記事では、BigQueryとSnowflakeをアーキテクチャ・機能・コスト・パフォーマンス・セキュリティの各観点で比較し、クラウド環境や業務要件に応じた選定の判断軸を整理します。さらに、DWH選定後に必要となるデータ連携の視点も加え、分析基盤の全体像を把握できる構成にしています。
目次
- BigQueryとSnowflakeとは
- アーキテクチャの違い
- 機能比較
- コスト構造の比較
- パフォーマンス比較
- セキュリティ比較
- 自社に合った選び方
- データ連携の視点
- Reckoner(レコナー)を使ったデータ連携
- まとめ
BigQueryとSnowflakeとは
BigQueryとSnowflakeはどちらも、クラウド上でペタバイト規模のデータを高速に処理できるDWHです。従来のオンプレミス型DWHと異なり、初期投資不要でスモールスタートができ、データ量やアクセス負荷に応じて柔軟にスケールできる点が共通しています。しかし、提供元と設計思想が根本的に異なるため、導入前に両者の違いをしっかり把握しておくことが重要です。
BigQueryの概要
BigQueryはGoogle Cloudが提供するサーバーレス型DWHです。インフラ管理が一切不要で、SQLを書くだけで大規模なデータ分析をすぐに始められる点が最大の特徴です。内部ではGoogleが社内の大規模データ分析向けに開発した分散クエリエンジン「Dremel」を採用しており、数ペタバイト規模のデータに対しても数秒から数分でクエリ結果を返す処理能力を持ちます。Vertex AIなどGoogle Cloudの各種サービスのほか、Looker StudioやGoogle Analytics(BigQuery Exportによる連携)とも深く統合されており、データ収集から分析・機械学習活用までを一気通貫で整備できる点も強みです。
Snowflakeの概要
Snowflakeはストレージとコンピュートリソースを分離した独自アーキテクチャを持つクラウドネイティブDWHです。AWS・Azure・Google Cloudの3大クラウドプロバイダーすべてで動作するマルチクラウド対応が最大の特徴で、特定のクラウドベンダーに縛られることなく運用できます。仮想ウェアハウス(Virtual Warehouse)という独立した計算リソースをチームや用途ごとに分割して割り当てられる仕組みを持ち、大規模な同時実行にも柔軟に対応できます。
アーキテクチャの違い
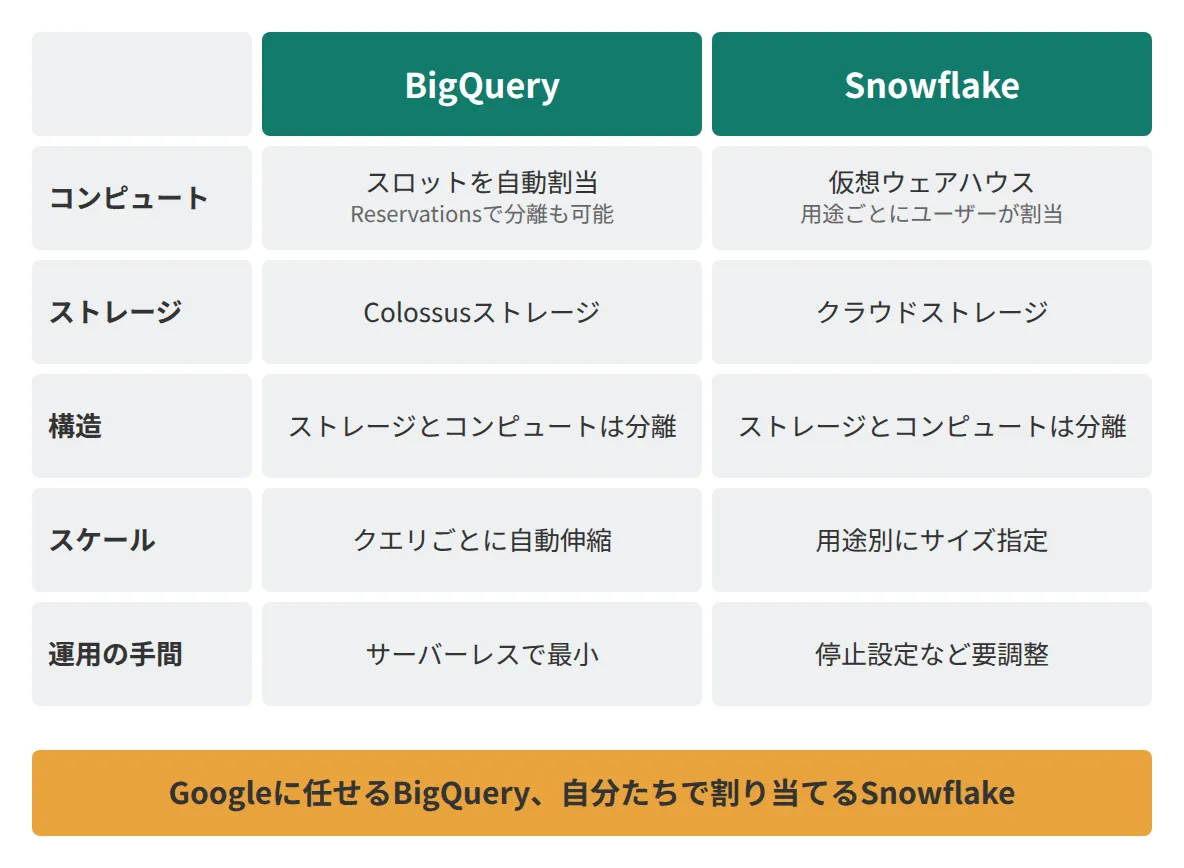
BigQueryとSnowflakeの差異を理解するうえで最も重要なのが、アーキテクチャの設計思想の違いです。一言で表すなら、BigQueryは「インフラをGoogleに任せる」設計、Snowflakeは「インフラを用途ごとに自分たちで割り当てる」設計です。この違いがコスト管理や運用方法の違いとして表れてきます。
サーバーレス型の特徴
BigQueryは完全なサーバーレス設計を採用しています。クラスター設定やウェアハウスの管理は一切不要で、ユーザーはSQLクエリを実行するだけです。計算リソースは「スロット」という単位で自動的に割り当てられ、大規模クエリも小規模クエリも同じインターフェースで処理されます。この設計はデータエンジニアが少ない環境でも即戦力として活用できる点で優れており、運用管理コストを最小化したいチームに向いています。
一方で、オンデマンド課金ではスロットの割り当てをGoogleに任せる形になります。リソースを細かく制御したい場合は、BigQuery EditionsのReservationsを使い、スロット数を予約したり、チームやワークロードごとに割り当てを分けたりする設定が必要です。
ストレージ・コンピュート分離
Snowflakeはストレージ層・コンピュート層・クラウドサービス層の3層構造を採用し、ストレージとコンピュートを独立してスケールできます。仮想ウェアハウスをチームや用途ごとに分割できるため、データサイエンスチームが重いクエリを実行していても、営業チームのダッシュボード更新へのパフォーマンス影響を抑えられます。未使用時の自動停止(オートサスペンド)設定でコストの無駄を減らせる点もメリットです。ただし、ウェアハウスのサイジングやオートサスペンドの閾値設定など、ある程度の運用知識が求められる点には留意が必要です。
<BigQueryとSnowflakeのアーキテクチャ比較>
機能比較
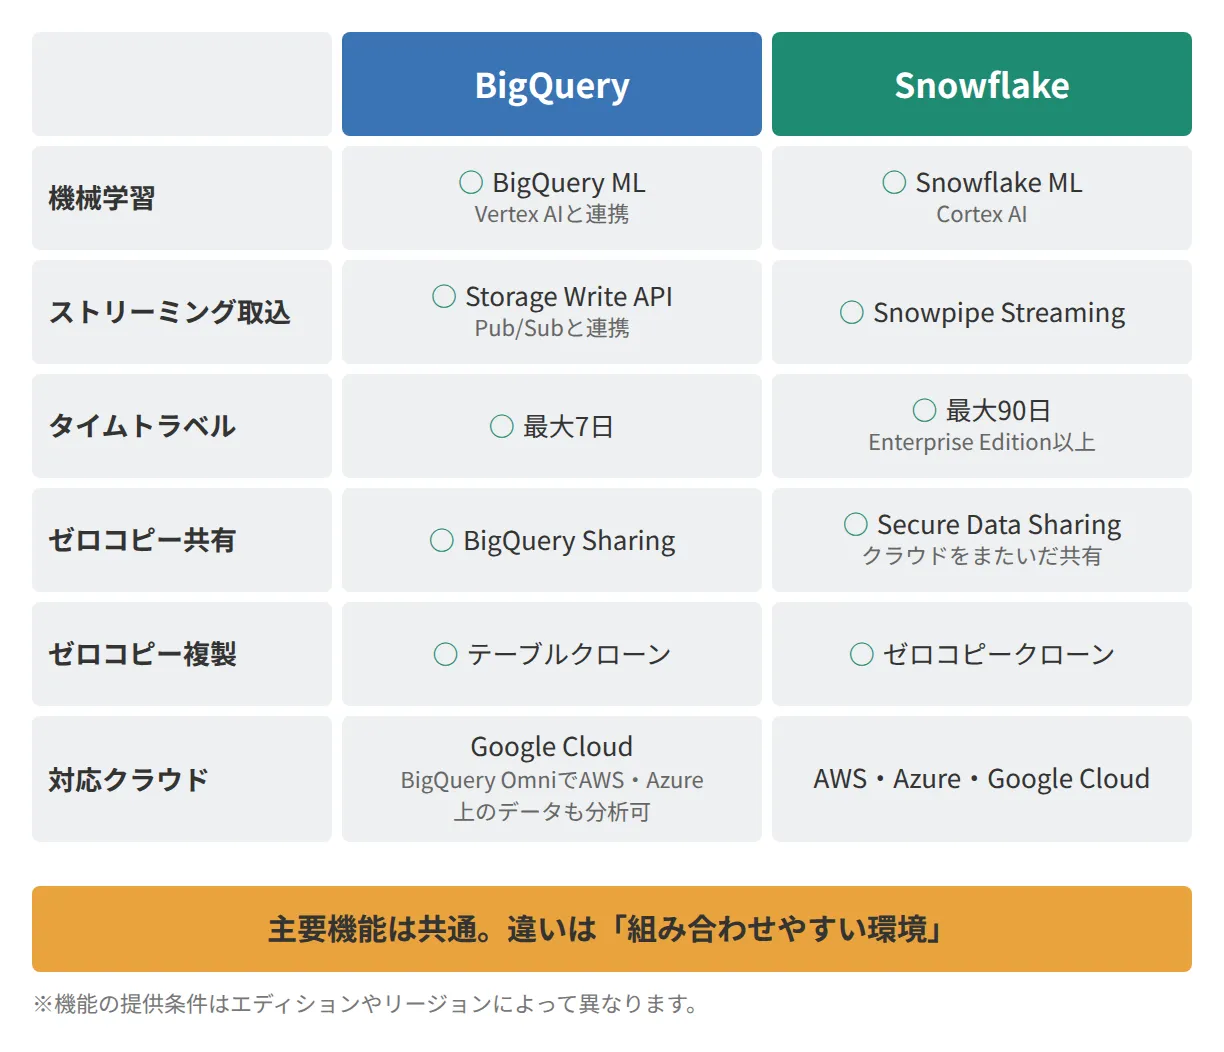
機械学習、リアルタイムのデータ取り込み、過去データの復元(タイムトラベル)、データを複製せずに共有する機能(ゼロコピー共有)といった主要な機能は、現在では両サービスともに備えています。SnowflakeにはSnowflake MLやCortex AI、Snowpipe Streamingがあり、BigQueryにもタイムトラベルやBigQuery Sharingによるゼロコピー共有があります。違いが表れるのは、それぞれの機能がどのような環境と組み合わせやすいかという点です。
BigQueryの主な機能
BigQueryの代表的な機能として、BigQuery MLがあります。SQLだけで機械学習モデルの構築・推論を行えるため、Pythonなど別の言語やツールを用意しなくても、データ分析と機械学習を一貫したワークフローで進められます。Vertex AIなどGoogle CloudのAI基盤とそのまま連携できるため、より高度な機械学習パイプラインへの拡張も容易です。また、Pub/Subなどと組み合わせてストリーミングデータを取り込みやすく、マーケティングキャンペーンのリアルタイムモニタリングやIoTセンサーデータの即時分析にも活用できます。
Snowflakeの主な機能
Snowflakeの代表的な機能として、Time Travelがあります。過去のデータ状態に遡って参照・復元できる機能で、Enterprise Edition以上では最大90日間(Standard Editionは最大1日)の保持期間を設定できます。BigQueryにも同様の機能(最大7日間)がありますが、より長い期間遡れる点がSnowflakeの特長です。またSecure Data SharingおよびSnowflake Marketplaceを使えば、データをコピーせずに他社と共有できます。BigQueryもBigQuery Sharingでゼロコピー共有に対応していますが、Snowflakeは異なるクラウドやリージョンを利用するSnowflakeユーザーとも共有しやすい点が強みです。さらにゼロコピークローンを使えば、データを複製せずに開発・テスト環境を即座に作成できます。
<機能・スペック比較表>
コスト構造の比較
両サービスともストレージとコンピュートの2軸で課金される点は共通ですが、計算方式が根本的に異なります。自社のワークロード特性(どのくらいの頻度で、どれくらいの量のデータを、どのような処理にかけるか)を踏まえてどちらが有利かを判断することが重要です。なお、料金はリージョンや契約形態によって変動するため、最新の価格は各サービスの公式サイトでご確認ください。
BigQueryの課金モデル
BigQueryのコンピュートコストは、「オンデマンド課金」と「容量課金(BigQuery Editions)」から選択できます。オンデマンド課金はクエリが実際に処理したデータ量に応じて課金される従量制で、利用頻度が断続的な場合や小規模ワークロードに向いています。容量課金(BigQuery Editions)は、使用したスロット時間に応じて課金される方式です。一定量のスロットを予約したり、負荷に応じてオートスケーリングさせたりできるほか、エディションによっては1年・3年のコミットメント契約で単価を抑えることも可能なため、安定した大規模ワークロードを抱える組織に適しています。ストレージは長期保存データに対する割引が設けられており、保存期間が長いデータが多い場合はコストをさらに抑えることができます。アクティブストレージと長期保存ストレージの単価差は東京リージョンでも設けられているため、データライフサイクル管理とセットで検討すると効果的です。
Snowflakeの課金モデル
Snowflakeのコンピュートコストは、仮想ウェアハウスのサイズと稼働時間に応じた「クレジット課金」が基本です。仮想ウェアハウスのサイズはX-Smallから複数段階があり、サイズが1段階上がるとクレジット消費量はおよそ2倍になります。クレジット単価は契約プランや契約形態によって異なります。未使用時の自動サスペンド設定によりコストの抑制は可能ですが、大規模運用では複数のウェアハウスが同時稼働するケースが増え、予期せぬ費用増加が生じることがあるため、継続的な利用状況の監視と最適化が重要です。ストレージはオンデマンド(従量課金)と事前購入の2パターンがあり、事前購入のほうが単価を抑えられます。
パフォーマンス比較
処理性能の面でも、BigQueryとSnowflakeはそれぞれ得意とする領域が異なります。どちらが優れているかはワークロードの性質によって大きく変わるため、自社の利用シナリオに照らして判断することが重要です。
クエリ速度と同時実行性
BigQueryはDremelエンジンによる大規模データの高速スキャンが強みで、単発の大規模クエリやアドホックな分析に向いています。クエリ結果のキャッシュはデフォルトで有効(24時間保持)なため、同じクエリを繰り返し実行する場合はコストを抑えつつ高速に応答できます。多数のユーザーが同時に利用する環境でも、Reservationsでワークロードごとにスロットを分ければ、処理同士の干渉を抑えられます。
一方Snowflakeは、仮想ウェアハウスごとに独立した計算リソースを割り当てる設計のため、用途やチームごとにリソースを分けるのが標準的な使い方です。同時アクセスが増えた場合も、マルチクラスターウェアハウス(Enterprise Edition以上)でクラスターを自動的に追加して対応できます。リソースの分け方を自分たちで設計・管理したい場合は、Snowflakeの構成が分かりやすいでしょう。
スケーラビリティの違い
BigQueryの自動スケーリングは操作不要で、ユーザーが設定を意識しなくても大規模ワークロードに対応します。BigQueryもストレージとコンピュートが分離されたアーキテクチャですが、計算リソースの割り当ては基本的に自動で行われます。一方Snowflakeは、仮想ウェアハウスのサイズや稼働をユーザーが直接指定し、必要なときだけコンピュートを強化する運用が可能です。コストとパフォーマンスを自分たちで細かく調整したい場合は、Snowflakeの設計が合いやすいでしょう。
セキュリティ比較
金融・医療・公共など、規制対応が求められる業界の担当者の方にとって、セキュリティ機能は選定の重要な判断軸のひとつです。
BigQueryとSnowflakeはどちらも、データの暗号化(転送時・保存時)とロールベースのアクセス制御を標準で備えており、エンタープライズ用途に十分なセキュリティレベルを持っています。BigQueryはGoogle Cloud IAM(Identity and Access Management)でアクセス制御を行うため、Google Cloud全体のアクセスポリシーをBigQueryにも一元適用できます。すでにGoogle Cloudを活用している組織であれば、既存の権限管理の仕組みをそのまま活用できる点が利点です。
Snowflakeはマルチクラウド環境をまたいでもRBACポリシーを一貫して適用できる点が差別化要素です。AWS・Azure・Google Cloudのいずれで動作していても、統一された権限管理を維持できます。加えてTime Travel機能とFail-safe機能(Time Travel期間終了後さらに7日間、Snowflakeがデータを保持する仕組み。復旧はSnowflakeサポートへの依頼が必要)により、誤操作によるデータ損失リスクも低減できます。
自社に合った選び方
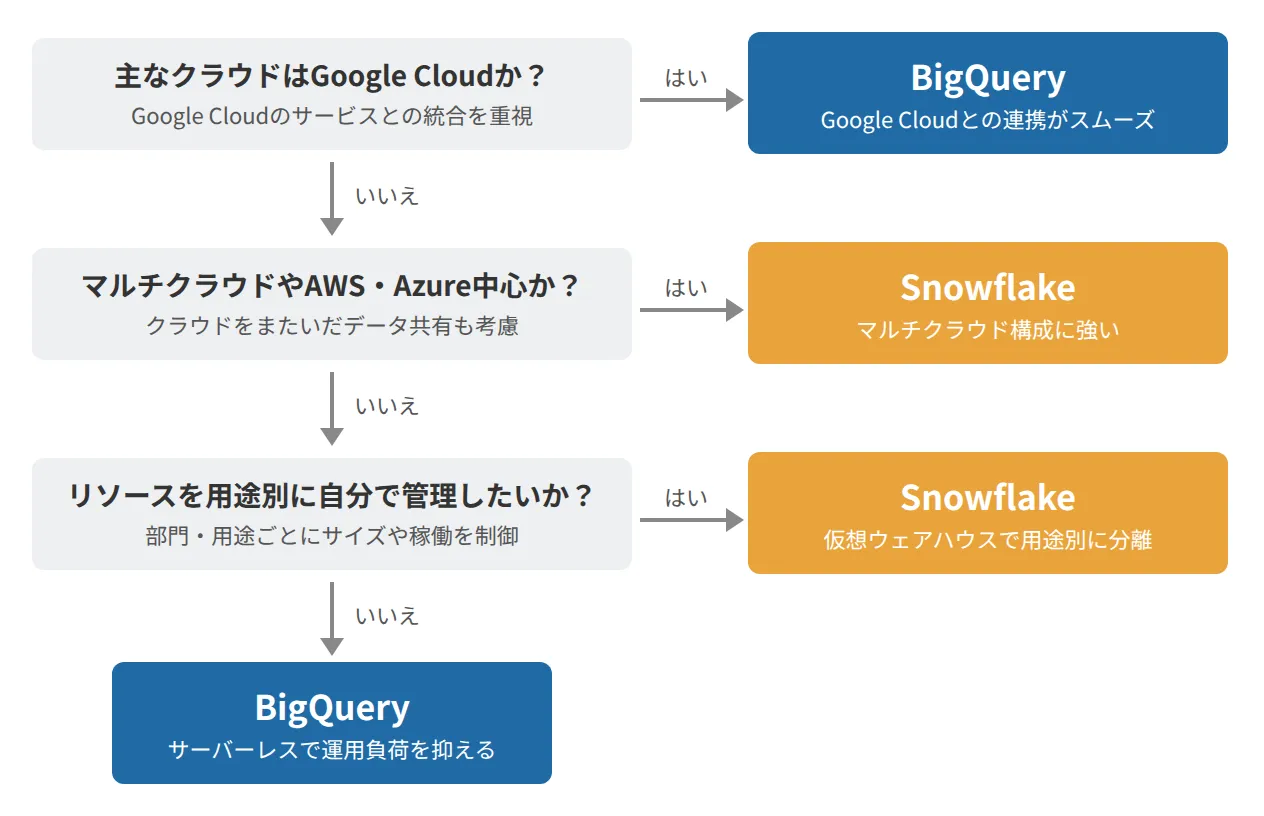
アーキテクチャ・機能・コスト・パフォーマンス・セキュリティの特性を踏まえたうえで、実際の選定は「クラウド環境」「ワークロード特性」「チームの運用スキル」という3つの軸で判断するのが効果的です。
Google Cloud中心ならBigQuery
すでにGoogle Cloudを中心に技術スタックを構築している組織にとって、BigQueryは最も自然な選択肢です。Vertex AI・Pub/Sub・Cloud StorageなどGoogle Cloudのサービスとシームレスに連携できるほか、Looker Studio・Google Analytics・Google広告といったGoogleのサービスのデータもBigQueryに集約しやすいため、データ収集から分析・機械学習活用までを一気通貫で整備できます。サーバーレス設計により専任のデータエンジニアが少ない環境でも運用できるため、運用管理の負担を抑えたい場合にも適しています。
マルチクラウドならSnowflake
AWS・AzureといったGoogle Cloud以外のクラウドを主に利用している場合、あるいは複数クラウドをまたぐマルチクラウド戦略を採用している場合は、Snowflakeが有力な選択肢となります。どのクラウドプロバイダー上で動作していても操作感やセキュリティポリシーが変わらないため、一貫した管理が可能です。複数部門・複数チームが同時にDWHを利用する大規模運用や、社外パートナーとのデータ共有が必要な場合にもSnowflakeの機能が活きます。
選定チェックリスト
以下の表を参考に、自社の状況に当てはめて判断してください。
| 判断軸 | BigQueryを選ぶ | Snowflakeを選ぶ |
| 主なクラウド環境 | Google Cloud中心 | AWS・Azure中心、またはマルチクラウド |
| 重視するワークロード | Google Cloudのサービスと組み合わせた分析・ML活用 | ワークロードごとにリソースを分けた大規模運用 |
| 運用管理コスト | 最小化したい(サーバーレス優先) | きめ細かなリソース制御が必要 |
| コスト管理方針 | スキャン量ベースのオンデマンド、または容量ベース(Editions) | 仮想ウェアハウスのサイズ×稼働時間に応じたクレジット課金 |
| データ共有ニーズ | Google Cloud上でのデータ共有・統合を優先 | 異なるクラウドを使う社外パートナーとも共有したい |
<DWH選定フロー>
データ連携の視点
DWHを選定した後に必ず直面するのが、「どうやってデータをDWHに送り込むか」という課題です。BigQueryやSnowflakeは大量データを高速に処理できる優れたサービスですが、そのなかにデータが存在しなければ分析は始まりません。基幹システム・SaaS・データベースなど多様なデータソースからデータを継続的に取り込む仕組み、すなわちデータパイプライン(ETL)の整備がDWH活用の前提条件となります。
BigQuery連携のポイント
BigQueryへのデータ連携には、Cloud Storageからの読み込みやPub/Subを使ったストリーミングのほか、BigQuery Data Transfer Serviceが利用できます。Data Transfer Serviceは、Google広告などのGoogleサービスやAmazon S3、一部のSaaS・データベースからの定期転送に対応したマネージドの連携機能です。ただし対応するデータソースは限られるため、kintoneなどの国内SaaSや社内の基幹システムからデータを取り込む場合は、個別に連携処理を実装するか、ETLツールを活用するのが一般的です。
Snowflake連携のポイント
SnowflakeはSnowpipe Streamingというストリーミングインジェスト機能を備えており、リアルタイムに近い形でデータを取り込める柔軟な仕組みを持ちます。またマルチクラウド対応のため、AWS・Azure・Google CloudそれぞれのデータソースからSnowflakeへの連携をクラウドをまたいで一元管理できます。ETLツールを活用することで、複数のSaaSや基幹システムからSnowflakeへのパイプラインをノーコードで構築でき、エンジニアなしでも運用の効率化を図れます。BigQueryとSnowflakeはどちらも主要ETLツールのコネクタ対象となっているため、選択肢は豊富です。
Reckoner(レコナー)を使ったデータ連携
BigQueryのData Transfer ServiceやSnowflakeのデータ取り込み機能など、DWH側にも標準の連携手段は用意されています。ただし、対応するデータソースはサービスごとに限られ、取り込む前のデータ加工や、DWHの分析結果をSaaSへ書き戻すリバースETLまでは対応できないケースも少なくありません。また、連携元ごとに別々の仕組みを使うと、設定画面やエラー対応が分散し、運用の負担が大きくなります。ETLツールを使えば、こうした連携を1つの画面でまとめて設計・運用できます。
ETLツールによるDWHへのデータ連携の具体的な選択肢として、Reckoner(レコナー)があります。ReckonerはBigQuery・Snowflakeの両方にコネクタを標準装備したクラウド型ノーコードETLツールで、GUIによる直感的な操作でデータパイプラインを構築できます。
BigQueryへの活用例
Reckonerを使ったBigQueryへの連携では、kintone・PostgreSQL・SQL Server・Oracle Databaseなどのデータを定期的にBigQueryへ自動連携するパイプラインをノーコードで構築できます。SQLの知識がない非エンジニア部門の担当者でも、GUIの画面操作だけでBigQueryへのデータ取り込みフローを設定・運用できる点が特長です。またBigQueryで集計・分析した結果をSalesforceなど別のSaaSに戻す「リバースETL」にも対応しており、分析結果を営業・マーケティング現場へ素早くフィードバックするフローも構築できます。
リバースETLの仕組みや活用方法は「リバースETLとは?ETLとの違い・仕組み・活用事例を解説」で詳しく解説しています。
Snowflakeへの活用例
SnowflakeへのデータパイプラインもReckonerで同様に構築できます。Salesforce・kintone・Google DriveのデータをSnowflakeへ定期自動連携するほか、Amazon S3からSnowflakeへのバッチ取り込み、SnowflakeからkintoneへのリバースETLにも対応しています。マルチクラウド環境でも、Reckonerの一元管理画面からワークフローを設定・スケジュールできるため、複数クラウドをまたいだデータ連携の運用負荷を大幅に軽減できます。
まとめ
BigQueryとSnowflakeはどちらも優れたクラウド型DWHですが、設計思想と強みが大きく異なります。BigQueryはGoogle Cloudとの深い統合とサーバーレス設計に強みを持ち、Google Cloudを中心に技術スタックを構築している組織や、データエンジニアのリソースが限られた環境に向いています。一方Snowflakeは、マルチクラウド対応と仮想ウェアハウスによる柔軟なリソース管理が強みで、AWS・Azureを主に利用する環境や、複数クラウドをまたいでデータを扱う組織に適しています。
選定においては「どちらが絶対に優れているか」ではなく、「自社のクラウド環境・ワークロード特性・運用体制に合っているか」を判断軸にすることが重要です。またDWHを選定した後は、各種SaaSや基幹システムからデータを継続的に送り込むETL基盤の整備が必要です。Reckonerはその構築をノーコードで実現できるツールとして、BigQuery・Snowflakeどちらの環境でも活用できます。データ連携基盤の整備についてお困りの担当者の方は、ぜひお気軽にご相談ください。
著者